TP 7 — Un programme en flash externe
Objectifs
comprendre pourquoi le programme du robot ne tient pas dans la flash du microcontrôleur, et où il s’exécute ;
faire démarrer un programme depuis la flash QSPI externe, derrière un chargeur d’amorçage (bootloader) ;
modifier un script d’édition de liens ;
mesurer le coût de l’exécution en flash externe, et le rôle du cache d’instructions.
Durée indicative : deux séances de 3 h. Prérequis : TP 2 — Priorités et ordonnancement.
Ce qu’il faut savoir
128 Kio de flash interne
Le STM32H750 n’a que 128 Kio de flash interne. Le firmware du robot, avec
micro-ROS, en fait plus de 400. Il vit donc dans une flash externe de
8 Mio, reliée par un bus QSPI, et s’y exécute en place (XIP,
eXecute In Place) : le contrôleur QUADSPI, en mode memory-mapped, fait
apparaître la flash à l’adresse 0x90000000, et le cœur y lit ses
instructions comme dans n’importe quelle mémoire.
Le chargeur d’amorçage
Au démarrage, le cœur exécute toujours la flash interne. Un petit programme y est installé — le bootloader du RatBot, 364 octets — qui :
configure les six broches de la QSPI ;
passe la flash externe en mode memory-mapped, à
0x90000000;vérifie que l’image commence par un pointeur de pile plausible ;
masque les interruptions, place la table des vecteurs à
0x90000000(registreSCB->VTOR), et saute au programme.
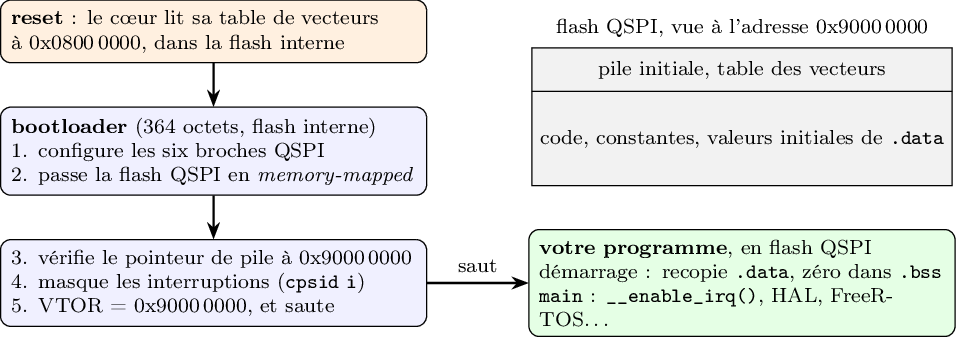
Le démarrage : le bootloader, en flash interne, rend la flash QSPI lisible puis y saute.
Le programme placé dans la flash externe est un programme ordinaire, à trois
différences près : il est lié à l’adresse 0x90000000 ; il ne doit
pas réinitialiser la QSPI qui le fait tourner ; et il trouve les
interruptions masquées.
Le coût : une mémoire lente, et un cache
La flash interne livre 256 bits d’instructions en quelques cycles. La flash QSPI, lue ici sur un seul fil à 16 MHz, met plusieurs microsecondes pour la même quantité. Sans précaution, le programme ralentit énormément.
Le Cortex-M7 a un cache d’instructions (I-cache) de 16 Kio : les instructions lues récemment y restent, et une boucle qui tient dans le cache tourne à pleine vitesse. Tant que le code utile tient dans le cache, la lenteur de la QSPI ne se voit presque pas. Quand il ne tient plus, chaque défaut de cache coûte une lecture en flash externe.
C’est exactement ce qui est arrivé au robot : à mesure que des fonctions s’ajoutaient, la boucle de publication micro-ROS est passée de 105 à 27 Hz, chassée du cache par le reste du code. Le TP 8 montre comment on l’a corrigé.
Étape 1 — La mesure de référence, en flash interne
Créez un projet
rtos_tp07_xipcomme au TP 2 (FreeRTOS CMSIS_V2, Timebase TIM6, UART5 etprintf, LED_1 en sortie), avec une tâchebenchTask.Dans System Core → CORTEX_M7, laissez CPU ICache et CPU DCache désactivés pour l’instant, et réglez MPU Control Mode sur MPU NOT USED (le MPU sera vu plus tard).
Écrivez une fonction de calcul, un CRC-32 logiciel, bit par bit, sur un tableau de 4 Kio :
static uint32_t crc32(const uint8_t *p, uint32_t n)
{
    uint32_t crc = 0xFFFFFFFFu;

    while (n--)
    {
        crc ^= *p++;
        for (int k = 0; k < 8; k++)
        {
            crc = (crc >> 1) ^ (0xEDB88320u & (0u - (crc & 1u)));
        }
    }
    return ~crc;
}
Dans
benchTask, toutes les secondes, mesurez la durée d’un appel en cycles avecDWT->CYCCNT(TP 6), et affichez-la avec la valeur du CRC.Programmez la carte normalement (en flash interne, depuis CubeIDE) et relevez la mesure.
Question
Combien de cycles par octet traité ? Le compilateur est-il en
-O0ou en-O2(Project → Properties → C/C++ Build → Settings → Optimization) ? Gardez le même réglage pour toutes les mesures.
Solution de l’étape 1
#define BENCH_LEN 4096u
static uint8_t g_data[BENCH_LEN];

__attribute__((noinline)) static uint32_t crc32(const uint8_t *p, uint32_t n)
{ /* … la fonction du sujet … */ }

void StartBench(void *argument)
{
    (void)argument;
    CoreDebug->DEMCR |= CoreDebug_DEMCR_TRCENA_Msk;
    DWT->CYCCNT = 0u;
    DWT->CTRL  |= DWT_CTRL_CYCCNTENA_Msk;
    for (uint32_t i = 0u; i < BENCH_LEN; i++) { g_data[i] = (uint8_t)(i * 7u); }

    for (;;)
    {
        uint32_t t0  = DWT->CYCCNT;
        uint32_t crc = crc32(g_data, BENCH_LEN);
        uint32_t cy  = DWT->CYCCNT - t0;

        printf("VTOR %08lx  crc32 %08lx : %lu cycles, %lu cycles/octet\r\n",
               (unsigned long)SCB->VTOR, (unsigned long)crc,
               (unsigned long)cy, (unsigned long)(cy / BENCH_LEN));
        osDelay(1000);
    }
}
noinline empêche le compilateur d’insérer le code de crc32
directement dans la tâche : la fonction reste une fonction à part, à une
adresse qu’on retrouve dans le .map, et qu’on pourra déplacer en
mémoire au TP 8.
On affiche le CRC. Sans cela, le compilateur pourrait constater que le résultat ne sert à rien, et supprimer le calcul : la mesure afficherait zéro cycle. Utiliser le résultat garantit qu’on mesure bien le calcul.
Réponse à la question 1
1. Le coût par octet. En -O2, de l’ordre d’une dizaine de
cycles par octet : la boucle interne fait 8 tours de 3 ou 4 instructions,
et le Cortex-M7, qui peut exécuter deux instructions par cycle, en absorbe
une partie. En -O0 (le réglage par défaut de la configuration Debug),
chaque variable est relue et réécrite en mémoire à chaque opération : 4 à
5 fois plus lent.
Une mesure de performance n’a de sens qu’en précisant le niveau
d’optimisation, et en le gardant pour toutes les comparaisons. Pour mesurer
la vitesse réelle, on utilise -O2 (ou la configuration Release).
Étape 2 — Le même programme en flash externe
Avertissement
Cette étape remplace le contenu de la flash externe : le programme du robot sera effacé. Il se réinstalle à la fin du TP (Remettre la carte en état RatBot). Le bootloader du RatBot, lui, doit être présent en flash interne : si un TP précédent l’a écrasé, réinstallez-le d’abord.
Le script d’édition de liens. Ouvrez
STM32H750VBTX_FLASH.ldet changez la régionFLASH:FLASH (rx) : ORIGIN = 0x90000000, LENGTH = 8M
Tout le code, les constantes et les valeurs initiales des variables y seront désormais placés.
Ne pas toucher à la QSPI. Vérifiez que le périphérique QUADSPI n’est pas activé dans CubeMX : son initialisation couperait la flash pendant que le cœur l’exécute.
Les interruptions. Le bootloader les a masquées avant de sauter. Ajoutez en tout début de
main(USER CODE BEGIN 1) :__enable_irq();
Compilez, puis programmez la flash externe avec STM32CubeProgrammer et le greffon de la flash QSPI (external loader). Le fichier
.elfcontient les adresses : rien d’autre à préciser.STM32_Programmer_CLI -c port=SWD mode=UR \ -el <chemin>/STM32H7xx_W25Q128_WeActStudio.stldr \ -w Debug/rtos_tp07_xip.elf -v STM32_Programmer_CLI -c port=SWD mode=HOTPLUG -rst
Danger
Terminez toujours par
-rst(reset logiciel), jamais par-hardRst: après l’écriture, la puce QSPI reste dans un état que le bootloader ne sait pas reprendre, et la carte ne démarre plus jusqu’à la prochaine coupure d’alimentation.Vérifiez que le programme tourne depuis la flash externe en lisant le registre
VTOR:STM32_Programmer_CLI -c port=SWD mode=HOTPLUG -r32 0xE000ED08 0x4
Questions
Que vaut
VTOR? Et l’adresse de la fonctioncrc32(cherchez-la dans le fichier.map) ?Quelle durée mesurez-vous pour le même CRC ? Combien de fois plus lent qu’en flash interne ?
Retirez
__enable_irq(). Le programme démarre-t-il ? EtHAL_Delayappelé avantosKernelStart? Expliquez.
Solution de l’étape 2
Trois modifications, sans toucher au code des tâches :
/* STM32H750VBTX_FLASH.ld */
FLASH (rx) : ORIGIN = 0x90000000, LENGTH = 8M
/* main.c, USER CODE BEGIN 1 : la toute première instruction */
__enable_irq();
et QUADSPI non activé dans CubeMX.
Pourquoi c’est si simple. C’est l”éditeur de liens qui fixe les
adresses de tout le programme, d’après le script : changer l’origine de la
région FLASH suffit à tout reloger, sans toucher au code. Le code de démarrage recopie
toujours .data depuis la « flash » (la QSPI maintenant) vers la RAM, et
la table des vecteurs est au début de l’image, à 0x90000000, là où le
bootloader a pointé VTOR.
Pourquoi pas de QUADSPI. Le bootloader a déjà configuré le contrôleur
QSPI en mode memory-mapped. MX_QUADSPI_Init le réinitialiserait,
donc couperait l’accès à la flash… pendant que le processeur y lit ses
instructions : blocage immédiat, et impossible à déboguer.
Réponses aux questions 2 à 4
2. VTOR et l’adresse de crc32. VTOR vaut 0x90000000 : la table
des vecteurs d’interruption est dans la flash externe, c’est la preuve que
le bootloader a sauté vers votre programme. crc32 a une adresse en
0x9000xxxx. Dans un pointeur de fonction (ou dans la table des
vecteurs), cette adresse est impaire : le bit 0 à 1 indique au
processeur que le code est en jeu d’instructions Thumb, le seul que
connaît un Cortex-M.
3. Sans cache d’instructions. Le même CRC est beaucoup plus lent, d’un à deux ordres de grandeur selon le code. Chaque lecture d’instructions en flash externe est une transaction sur le bus QSPI : la commande de lecture (8 bits), l’adresse (24 bits), puis les données, sur un seul fil à 16 MHz dans la configuration du bootloader. Lire 32 octets d’instructions demande 8 + 24 + 256 = 288 bits, soit 18 µs : plus de mille cycles du processeur, qui attend.
4. Sans __enable_irq(). Le programme démarre quand même, si
FreeRTOS est présent : osKernelStart démasque les interruptions pour
lancer l’ordonnanceur, et les tâches tournent. Mais avant
osKernelStart, l’interruption de TIM6 (la base de temps de la HAL) est
masquée : HAL_GetTick() reste à 0. Un HAL_Delay dans l’initialisation
ne se termine jamais, et les délais d’attente de la HAL (qui reposent
sur HAL_GetTick) ne s’écoulent pas : une erreur qui devrait renvoyer
HAL_TIMEOUT bloque pour toujours. Sans FreeRTOS, le programme se
bloquerait au premier HAL_Delay.
Le bootloader masque les interruptions (cpsid i) avant de sauter pour
qu’aucune interruption ne survienne pendant la bascule, alors que la table
des vecteurs et la pile changent. C’est au programme lancé de les
rétablir : c’est une convention à connaître.
Étape 3 — Le cache d’instructions
Activez CPU ICache dans CORTEX_M7, régénérez, reprogrammez, et mesurez de nouveau.
Pour mettre le cache en difficulté, ajoutez une seconde fonction de calcul, volumineuse — par exemple vingt copies de
crc32sous des noms différents, appelées l’une après l’autre sur 256 octets chacune — de sorte que le code exécuté à chaque tour dépasse 16 Kio. La taille de chaque fonction se lit dans le fichier.map; pour grossir une copie, déroulez sa boucle (traitez 16 octets par tour, écrits à la main). Comparez les durées, par octet, à celles decrc32seule.
Questions
Avec le cache, l’écart entre flash interne et flash externe est-il encore visible pour
crc32seule ? Pourquoi ?Et quand le code qui tourne en boucle dépasse la taille du cache ?
La première mesure après le démarrage est-elle différente des suivantes ? Pourquoi ?
Solution de l’étape 3
Le cache s’active dans CubeMX (CPU ICache : Enabled), qui ajoute
SCB_EnableICache() au début de main. Pour le code volumineux, vingt
copies d’un CRC déroulé, générées par une macro :
#define STEP(c, poly)  c = ((c) >> 1) ^ ((poly) & (0u - ((c) & 1u)))
#define BYTE(c, b, poly) do { c ^= (b); STEP(c, poly); STEP(c, poly); STEP(c, poly); \
    STEP(c, poly); STEP(c, poly); STEP(c, poly); STEP(c, poly); STEP(c, poly); } while (0)
#define CRC_COPY(name, poly)                                                 \
    __attribute__((noinline)) static uint32_t name(const uint8_t *p, uint32_t n) \
    {                                                                         \
        uint32_t c = 0xFFFFFFFFu;                                             \
        for (; n >= 16u; n -= 16u, p += 16)                                   \
        {                                                                     \
            BYTE(c, p[0], poly);  BYTE(c, p[1], poly);  /* … */                \
            BYTE(c, p[14], poly); BYTE(c, p[15], poly);                       \
        }                                                                     \
        return ~c;                                                            \
    }

CRC_COPY(crc_a, 0xEDB88320u) CRC_COPY(crc_b, 0xEDB88321u) /* … jusqu'à crc_t */
(le fichier complet ci-dessous écrit les 16 BYTE en entier). Chaque copie
a sa propre constante, pour que le compilateur ne les fusionne pas en une
seule fonction. En -O2, une copie fait environ 1,5 Kio : les vingt font
près de 30 Kio, presque le double du cache. On les appelle l’une après
l’autre, sur 256 octets chacune, et on mesure le coût par octet.
Pourquoi dérouler. Une boucle courte tient en quelques dizaines d’octets : même vingt copies tiendraient dans le cache. Écrire 16 octets par tour, et les 8 étapes de chacun, multiplie la taille du code sans changer le calcul.
Réponses aux questions 5 à 7
5. crc32 seule, avec cache. L’écart avec la flash interne disparaît
presque. La boucle de crc32 ne fait que quelques dizaines d’octets :
au premier tour, elle est lue en flash externe et chargée dans le cache ;
tous les tours suivants (plus de 32 000) la lisent dans le cache, aussi vite
qu’en flash interne. Le coût de la QSPI n’est payé qu’une fois.
6. Quand le code dépasse le cache. Le coût par octet remonte nettement. Les vingt copies font près de 30 Kio, pour 16 Kio de cache : quand la copie 15 s’exécute, elle évince du cache les lignes des copies 1, 2, 3… qui devront être relues en flash externe au tour suivant. Chaque appel recommence avec un cache qui ne contient pas son code : ce sont des défauts de cache (cache misses) à répétition. Le programme est correct, il est seulement lent, et d’autant plus lent qu’on ajoute du code ailleurs — c’est exactement ce qui est arrivé au robot (105 → 27 Hz).
7. La première mesure. Elle est plus lente que les suivantes : au premier passage, le cache est vide, et tout le code est lu en flash externe (défauts dits obligatoires). Dès le deuxième passage, ce qui tient dans le cache y est déjà. En mesure de performance, on jette toujours la première mesure, ou on mesure explicitement les deux cas (« à froid » et « à chaud »).
Tout le code de la correction
taches.c
— compilé sans avertissement contre la HAL et le FreeRTOS 10.6.2 du
firmware RatBot.
Le fichier contient les fonctions des tâches, qui remplacent les
squelettes générés par CubeMX (dans main.c ou freertos.c selon la
version), et les extraits à placer dans les blocs USER CODE signalés en
commentaire. La configuration CubeMX attendue est rappelée en tête du
fichier, et les réponses aux questions à la fin.
Exercices supplémentaires
Ces exercices n’ont pas de correction.
Lire la flash externe : affichez au terminal les 16 premiers mots de
0x90000000. Reconnaissez le pointeur de pile initial et l’adresse du gestionnaire de reset.Les constantes : déclarez un grand tableau
const(16 Kio) et mesurez le temps de son parcours, en flash interne puis externe, avec et sans D-cache.Le bootloader : lisez
firmware/ratbot_bootloader/main.cdans le dépôt du projet. Pourquoi ne configure-t-il ni l’horloge, ni la RTC ?
Après le TP
La flash externe contient votre programme : réinstallez celui du robot, voir Remettre la carte en état RatBot.